Meta Muse Spark Open 要什么配置?显存、几张卡、Mac 能不能跑(2026)
直接回答
Muse Spark Open 总参数 816B、激活 42B,但部署时 816B 要整个装进显存。官方 4 位 NVFP4 版约 537 GB,要一台 4 卡的 B300 级 Blackwell 服务器,或者两台 512GB、四台 256GB 的 M5 Ultra Mac Studio 用 MLX 串起来;原版 BF16 约 1.65 TB,要 8 张 B300。社区最小的 1 位量化也有 175.6 GB,单张 RTX 4090、5090 没戏。许可证是 Meta 自己的 Muse Model License,不是 MIT:产品里要显著标注 Built with Muse Spark Open,对外卖模型 API、且公司加关联方任意连续 12 个月总收入超过 2000 万美元的,要先通知 Meta 并另签协议。阿里云百炼、硅基流动截至 2026-10-21(台北时间)都没有上架。
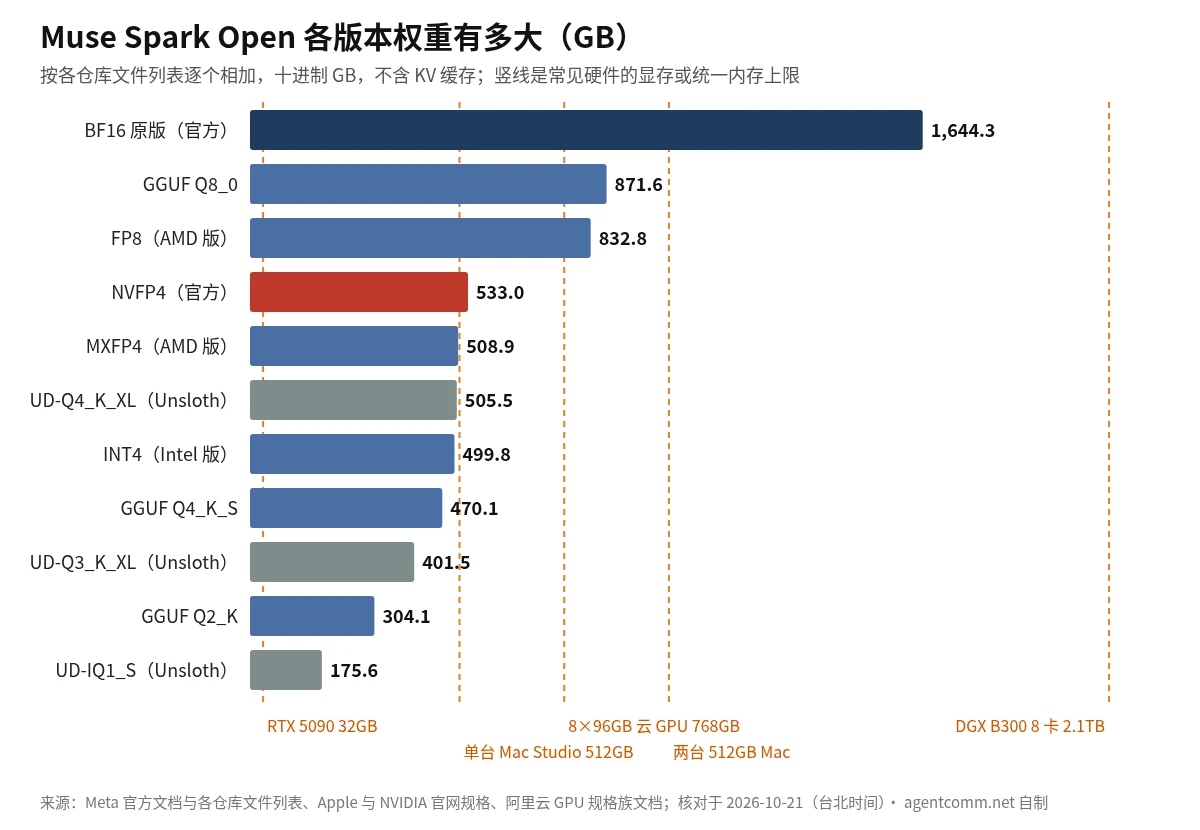
我们把官方 NVFP4 仓库 127 个权重分片的大小挨个加了一遍:533 GB。这还是 4 位的版本。
Muse Spark Open 的权重到底多大?
官方 4 位版 NVFP4 约 537 GB,原版 BF16 约 1.65 TB,这是 Meta 文档里的数(Get the model)。我们按文件列表加出来是 533.01 GB 和 1644.33 GB,差的几 GB 应该是取整口径,不影响选卡。
权重是 Meta 10 月 15 日放出来的。模型本体是 MoE,总参数 816B,单个 token 只激活 42B,上下文 1,048,576 tokens,能吃文字、图片、音频和视频,只输出文字(官方博客、官方文档)。激活 42B 只管每个 token 的计算量。显存那头官方文档说得很明白,部署时 816B 的完整权重都得装进去,硬件门槛按它算。
除了 Meta 的两个版本,AMD、Intel、llama.cpp 团队和 Unsloth 也各放了格式,大小如下:
| 格式 | 谁做的 | 实际大小 | 给什么硬件 |
|---|---|---|---|
| BF16 | Meta 官方 | 1644.33 GB | 8 张 B300,或 8 张 AMD MI355X / MI350X |
| NVFP4 | Meta 官方 | 533.01 GB | 一台 4 卡 B300 级 Blackwell;两台或四台 Mac Studio(MLX) |
| FP8 / MXFP4 | AMD | 832.75 / 508.86 GB | 8 张 MI355X / MI350X,vLLM |
| INT4 | Intel | 499.81 GB | 至强 6 处理器(如 6980P),SGLang |
| GGUF Q8_0 / Q4_K_S / Q2_K | llama.cpp 团队 | 871.65 / 470.07 / 304.08 GB | llama.cpp,CUDA、ROCm、Metal、CPU 都能跑 |
| 动态 GGUF | Unsloth | 175.64(UD-IQ1_S)到 505.50 GB(UD-Q4_K_XL) | 同上 |
硬件一栏来自官方 Hardware platforms 和 Run inference 页。大小不含 KV 缓存,十进制 GB;GGUF 要看图、听音频,还得另加一个 2.18 到 4.10 GB 的多模态投影文件。核对于 2026-10-21(台北时间)。
两台 Mac Studio 真能跑吗?
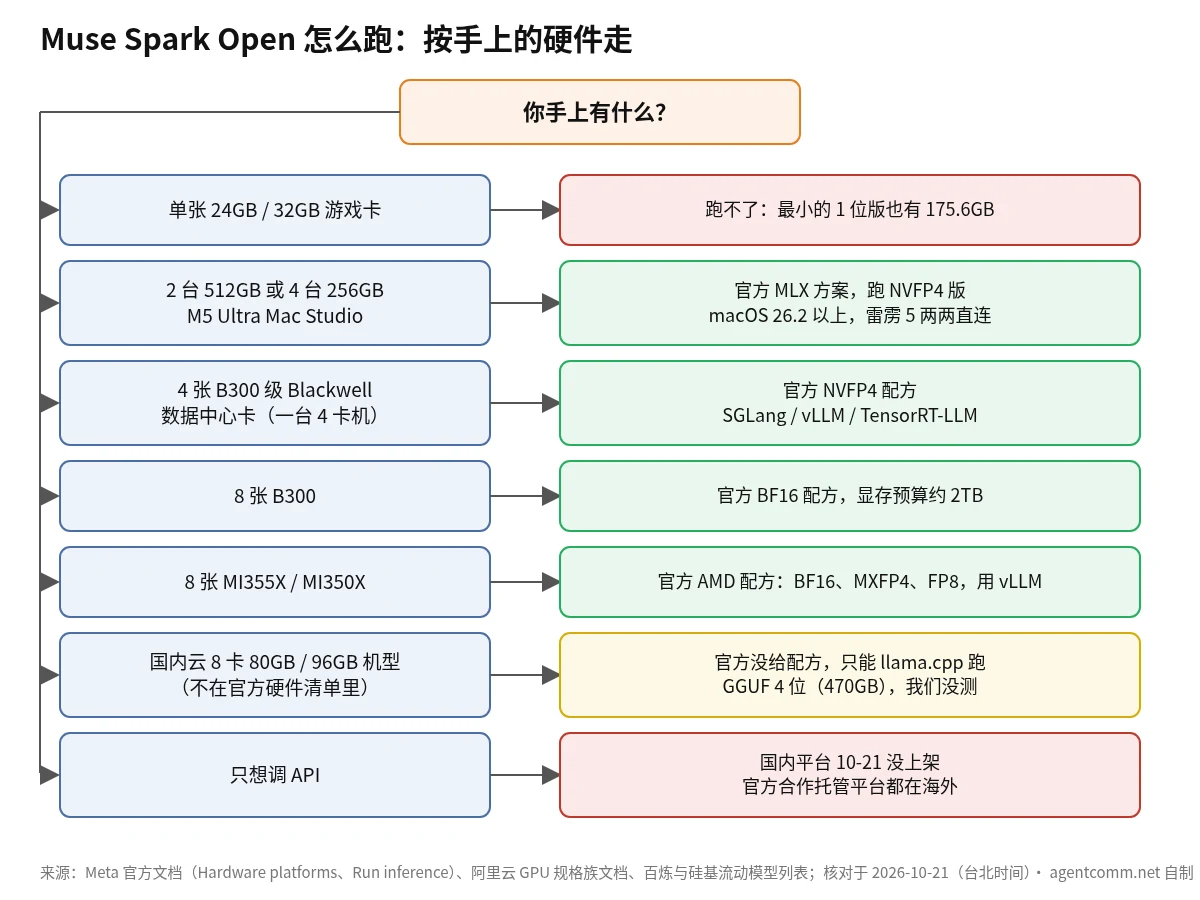
能,前提是 M5 Ultra 加顶配内存:两台各 512GB,或者四台各 256GB,跑官方 NVFP4 版。中文转述里常说的「两台 Mac」只是其中一种,官方硬件页同时写了四台 256GB 的方案,还说四台最快(Hardware platforms、Run inference › MLX)。
内存够了还不算完。官方 MLX 方案要求每台 macOS 26.2 以上、MLX 0.30.1 以上,任意两台 Mac 之间都要一条雷雳 5 直连,官方建议每两台之间接两根线,把带宽翻倍,四台的话每台都要连另外三台。权重也不是分着放的,每台都从自己的硬盘加载完整的 NVFP4,533 GB,硬盘只有 512GB 的配置直接出局。
苹果中国官网的 Mac Studio 技术规格 写着 M5 Ultra 默认 96GB,256GB 和 512GB 只能在 36 核中央处理器、80 核图形处理器那一档上选配。一台 512GB 装不下 533 GB 的权重,所以官方最少两台。
速度我们没测。官方博客只给了 M5 Ultra 1.2TB/s 的内存带宽,没写每秒能出多少 token。
一张 4090、5090 有戏吗?
没戏。社区里最小的 UD-IQ1_S 也有 175.6 GB,是 RTX 5090 32GB 显存的五倍多,RTX 4090 只有 24GB。
llama.cpp 能把装不下的层挪到内存里,显存加内存凑够就能启动。Meta 文档转引了 Unsloth 的估算:2 位版要 300 到 315 GB 总内存,4 位版要 470 到 500 GB。普通台式机插满内存也很难到这个数,就算凑到了,大部分计算压在 CPU 上,速度可想而知,1 位、2 位版掉多少分官方也没给。
在家想跑它,现实的只有 Mac 那条路,游戏卡别折腾了。
上云要几张卡?
官方验证过的只有三套:4 张 B300 级 Blackwell 跑 NVFP4,8 张 B300 跑 BF16,8 张 AMD MI355X 或 MI350X 跑 BF16、MXFP4、FP8(Hardware platforms)。BF16 官方建议按约 2TB 显存准备,NVIDIA 官网写的 DGX B300 一台 8 卡总显存 2.1TB,刚好卡在线上。
国内云的公开文档里,我们没找到 B300 规格。翻了 阿里云 GPU 实例规格族文档,离得最近的是 gn9gc:Blackwell 架构、支持 FP4,单卡 72GB,ecs.gn9gc-8x.64xlarge 八卡共 576GB。装下 533 GB 的 NVFP4 只剩四十来 GB 给 KV 缓存,长上下文基本别想。官方写的是 SM100 系列的 4 卡节点,gn9gc 用的 Blackwell 专业卡不在验证清单里,能不能直接跑官方配方我们没法保证,而且这个规格族还在邀测,要提工单申请。
同一份文档里的 gn8v(八卡 768GB)和 gn7e(八卡 640GB)装得下 470 GB 的 GGUF Q4_K_S,但都没有官方配方,只能走 llama.cpp,并发和吞吐跟官方 SGLang、vLLM 那套没法比。gn8v 文档还写着目前只开放海外等部分地域。
价格这里不写。阿里云 GPU 实例按地域、规格和计费方式定价,静态页上没有能直接抄的刊例价,得自己去控制台下单页或价格计算器看。八卡机按量开一天就不是小钱,先拿小模型把 llama.cpp 或 vLLM 的流程走通再说。阿里云 AIGC 活动页(推广链接) 主推函数计算的 Serverless GPU,页面例子是 16GB GPU 跑生图和语音克隆,装不下这个模型,拿来练手部署流程还行。
能拿来商用吗?
能,许可证免费,只是条款比 MIT、Apache 多几条。Meta 管它叫 Muse Model License,官方博客的说法是「有限的商业条款」。许可证全文随权重一起发布(LICENSE.md),从 Meta 官方下载要先登录并在页面上接受许可(Get the model、官方文档 License 一节)。
开头的授权段落读着像 MIT:免费使用、复制、修改、微调、蒸馏、再分发、出售都行。后面挂了条件,要守的是这三条:
① 所有副本和衍生品里附上版权声明、许可证和使用政策(Usage Policy),使用本身也不能违反使用政策。
② 每个用到它的产品或服务,要在界面、配套文档、官网或设置菜单里显著写上「Built with Muse Spark Open」。衍生模型也算:许可证把用它或它的输出训练、微调、蒸馏出来的模型都叫 Derivatives。拿它的输出蒸馏自家小模型,产品上照样得挂这行字。
③ 通过 API 或类似接口把模型能力卖给第三方(许可证叫 Model as a Service),而且公司加所有关联方在任意连续 12 个月里总收入超过 2000 万美元(或等值的其他货币),上线前要先通知 Meta、另签书面协议。
第③条最容易被转述歪。门槛算的是整个公司加关联方的总收入,不是这项 API 业务的收入。内部使用、研究、不卖模型接口的商业活动,或者把它嵌进自家产品当一个功能(只要这个产品本身不是卖模型服务),这一条都管不着。
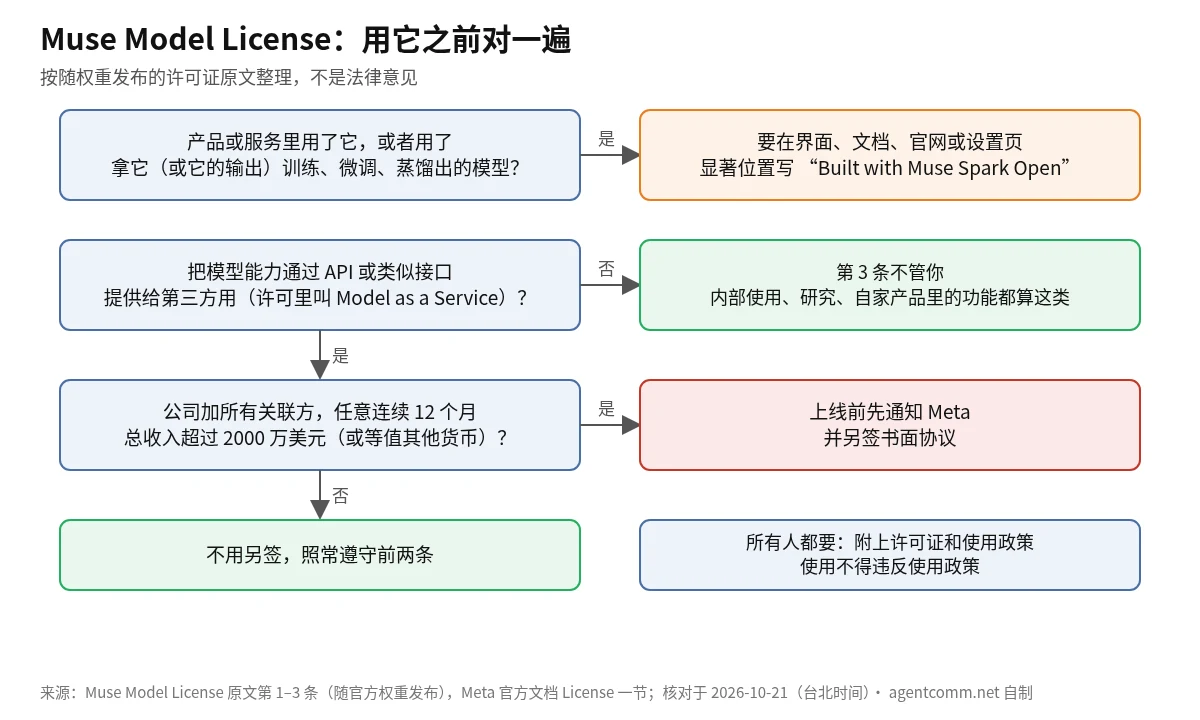
许可证第 4 条写明 Meta 不主张模型输出的所有权。上面是我们按原文做的整理,真要商用,以许可证原文为准。
国内能直接调 API 吗?
不能。10 月 21 日我们翻了 阿里云百炼模型列表 和 硅基流动模型广场,两边都上了 Kimi、GLM、DeepSeek 这些第三方模型,就是没有 Muse Spark Open,也没有别的 Meta 模型。
Meta 官方文档列出的托管平台全是海外服务商,没有一家国内平台(Run inference › Hosted providers)。眼下要在国内直接调 API,只能先用百炼上已经有的模型,阿里云 AI 福利页(推广链接) 上有百炼的 Token Plan 包月,页面写的是能抵扣百炼全量模型。
自己部署还有哪些坑?
思考关不掉。官方 llama.cpp 说明写得很直白:聊天模板默认 xhigh,传 none 会被拒,想少花 token 只能调到 low(Run inference)。接 Agent 的时候 max_tokens 要给足,TensorRT-LLM 那节专门提醒过,预算太小会全花在思考上,返回的正文是空的。
1M 上下文别真开满。官方 TensorRT-LLM 配置验证过的窗口是 49,152 tokens,文档说窗口越长 KV 缓存按比例涨;vLLM 示例命令却直接开到 1,048,576,照抄之前先算算显存。
所谓「桌面上就能跑」,桌子得放得下两台顶配 Mac Studio,再加两根雷雳 5 线。
来源和核对:模型参数、版本、硬件配方、部署要求和托管平台来自 Meta 官方博客和 Muse Spark Open 官方文档(含 Get the model、Hardware platforms、Run inference 三页)。各版本大小是我们把 Meta、AMD、Intel、llama.cpp 团队和 Unsloth 各自仓库的文件列表拉下来逐个相加的。许可条款按随权重发布的 Muse Model License 原文。硬件规格来自 Mac Studio 技术规格、NVIDIA DGX B300、NVIDIA RTX 4090 和 5090 产品页、阿里云 GPU 实例规格族文档。全部核对于 2026-10-21 晚(台北时间)。这个模型我们自己没跑过,所以文中不写速度,也不写云 GPU 价格。
常见问题
Muse Spark Open 最低要多大显存?
官方版本里最小的是 NVFP4,约 537 GB(我们把 127 个分片加起来是 533.01 GB),官方配方是 4 张 B300。社区量化里最小的是 Unsloth 的 UD-IQ1_S,175.64 GB,要靠 llama.cpp 把显存和内存合起来用。都不含 KV 缓存。核对于 2026-10-21(台北时间)。
激活参数只有 42B,为什么还要这么多显存?
它是 MoE 模型,每个 token 只算 42B,省的是算力。官方文档写明部署时 816B 的完整权重都要装进显存,所以显存门槛按 816B 算。
两台 Mac Studio 真能跑吗?
能,但要 M5 Ultra 的两台 512GB,或者四台 256GB,跑官方 NVFP4 版,用 MLX 分布式。每台要 macOS 26.2 以上、MLX 0.30.1 以上,每两台之间雷雳 5 直连,每台硬盘都要放得下完整的 533 GB 权重。官方说四台最快。速度我们没测。
Muse Spark Open 能免费商用吗?
大多数情况可以,但它不是 MIT 或 Apache。Muse Model License 要求在产品界面、文档、官网或设置页显著标注 Built with Muse Spark Open,用它或它的输出蒸馏、微调出来的模型也算;对外提供模型 API、且公司加关联方连续 12 个月总收入超过 2000 万美元(或等值其他货币)的,上线前要通知 Meta 并另签书面协议。内部使用、研究和自家产品里的功能不受这一条限制。
国内能直接调 Muse Spark Open 的 API 吗?
暂时不能。2026-10-21(台北时间)查阿里云百炼模型列表和硅基流动模型广场,都没有 Muse Spark Open。Meta 官方文档列出的托管平台都是海外服务商。
本文要点
- Muse Spark Open 总参数 816B、激活 42B,但部署时 816B 要整个装进显存。
- 官方 4 位 NVFP4 版约 537 GB,要一台 4 卡的 B300 级 Blackwell 服务器,或者两台 512GB、四台 256GB 的 M5 Ultra Mac Studio 用 MLX 串起来;原版 BF16 约 1.65 TB,要 8 张 B300。
- 社区最小的 1 位量化也有 175.6 GB,单张 RTX 4090、5090 没戏。
信息来源官方博客 · 官方文档 · Hardware platforms · Run inference
最后更新 · 价格核对 2026-10-21
引用本文Meta Muse Spark Open 要什么配置?显存、几张卡、Mac 能不能跑(2026) — https://www.agentcomm.net/zh/muse-spark-open-hardware/