部署 AI Agent 要什么配置的云服务器?只调 API、加向量库、跑本地小模型三种情况怎么选(2026)
直接回答
AI Agent 要多大的服务器,看模型跑在哪:模型走云端 API 时,Agent 本身很轻,Hermes 官方推荐 2 核、2–4 GB,买 2核4G 就够,阿里云 ECS 经济型 e 实例 2核2G 99 元/年也能跑;加向量库做知识库,Dify 自带 Weaviate 最低 2核4G,单独跑 Milvus 官方要求内存 8G 起、推荐 16G,按 4核8G 起步;想在 CPU 上跑本地小模型,我们实测 qwen3:8b 开 32K 上下文占 9.7 GiB、4 线程每秒约 4.7 个 token,至少 4核16G。腾讯云轻量应用服务器刊例价 2核4G 65 元/月、4核8G 230 元/月、4核16G 320 元/月,包年 85 折。核对于 2026-10-19。
快速推荐:按你的情况选
99 元/年,新老用户同价,续费同价锁到 2029-03-31,限购 1 台(核对于 2026-10-19)。跑一个只调 API 的 Agent 够用。
活动页写“轻量应用服务器4核4G3M,新用户首年仅需109元/年”,每个实名主体限 1 台,续费按官网价(核对于 2026-10-19)。
刊例价 320 元/月,包年 85 折约 3264 元,200M 峰值带宽不限流量(核对于 2026-10-19),内存够 Milvus 单机推荐值。
价格核对于 2026-10-19,活动价和库存随时变,下单前以官方页面为准。带 ↗ 的按钮是推广链接,价格不变。
本文怎么来的:配置要求来自 Hermes Agent 官方 Docker 文档、Dify 官方 Docker Compose 文档、Milvus 官方单机部署要求 和 Ollama 模型库 Qwen3 页面;价格来自 腾讯云轻量应用服务器价格总览(页面写最近更新 2026-09-24)、腾讯云轻量特惠页、阿里云 99 元套餐页、阿里云 OpenClaw/Hermes 部署页 和 阿里云轻量实例规格族文档,全部核对于 2026-10-19。本地模型的内存和速度是我们在自己一台 8 vCPU、16G 内存、无显卡的 Linux 机器上用 Ollama 0.40.6 测的,不是在云服务器上测的。
部署 AI Agent 要几核几 G?
看模型跑在哪。模型走云端 API,2核4G 就够;加一个独立向量库,按 4核8G 起步;要在没有显卡的服务器上跑本地小模型,至少 4核16G。
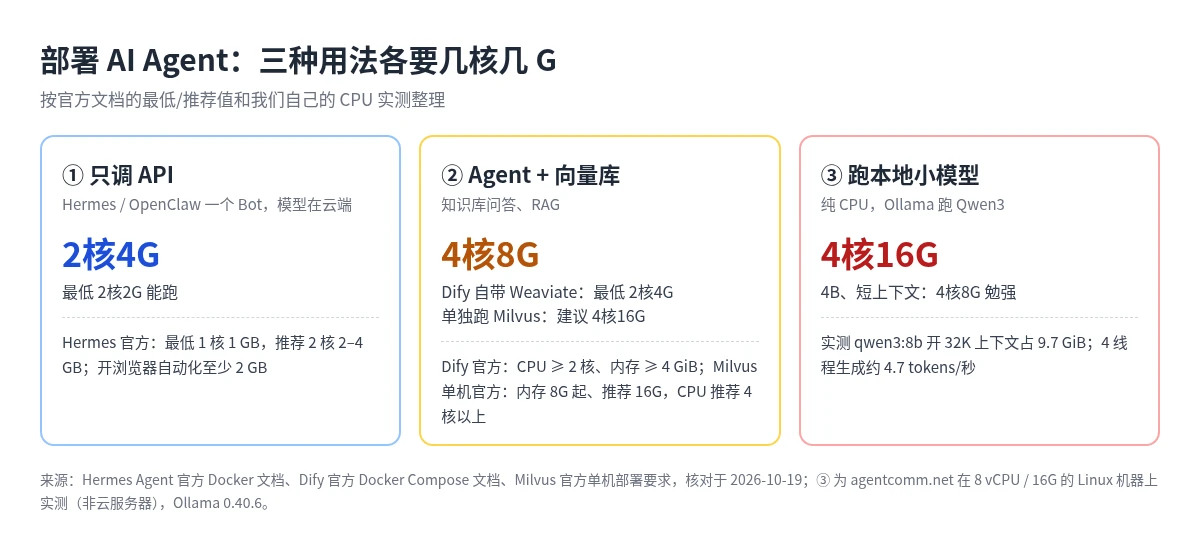
Agent 程序本身吃不了多少资源,它大部分时间在等模型回话。真正把内存吃满的是两样东西:向量库,和跑在本机的模型。
| 场景 | 最低 | 推荐 | 依据 |
|---|---|---|---|
| 只调 API(Hermes、OpenClaw 等) | 1 核 1 GB;开浏览器自动化 2 GB | 2 核 2–4 GB | Hermes Docker 文档 |
| Agent + Dify 自带 Weaviate | CPU ≥ 2 核,内存 ≥ 4 GiB | 4核8G(我们的估算,见下文) | Dify Docker Compose 文档 |
| Agent + Milvus 单机版 | 内存 8G | 内存 16G,CPU 4 核以上,SSD | Milvus 部署要求 |
| 纯 CPU 跑 4B–8B 小模型 | 4核8G(4B、短上下文) | 4核16G 或 8核16G | 我们的实测,见下文 |
核对于 2026-10-19。单个工具的详细配置见 Hermes Agent 部署要几核几 G 和 Dify 自部署要几核几 G。
只调 API 的 Agent,2核2G 够不够?
够跑。Hermes 官方写的最低是 1 核 1 GB,推荐 2 核 2–4 GB,开浏览器自动化要 2 GB 起。
2核2G 的问题是余量小:系统、Docker 加上一个 Chromium,内存很快就到顶,这时候 Agent 不会报“内存不足”,而是浏览器工具莫名其妙地失败。所以只聊天、只调接口用 2核2G;要它上网点网页,或者一台机器挂好几个 Bot,直接上 2核4G,一年也就差几百块。
阿里云的 ECS 经济型 e 实例 2核2G 是这一档里长期最省的,99 元/年,续费同价。腾讯云轻量应用服务器 锐驰型 2核4G 刊例价 65 元/月,包年 85 折约 663 元;新用户还可以看“4核4G3M 首年 109 元”的活动,但第二年按官网价续费。
Agent 加向量库要多大内存?
用 Dify 自带的 Weaviate,官方最低 2核4G;单独部署 Milvus,官方要求内存 8G、推荐 16G。
Dify 一套 Docker Compose 会起 API、Worker、Web、Postgres、Redis、Nginx、沙箱、SSRF 代理和 Weaviate 等一串容器,2核4G 是“能起来”的线。知识库文档一多、并发一上来,向量库和 Worker 抢内存,所以我们建议直接 4核8G——这是估算,我们没有对 Dify 做压测。Milvus 单独部署的门槛更明确:官方单机版要求 8G、推荐 16G 内存,CPU 推荐 4 核以上,还要求 SSD 和支持 SSE4.2、AVX 等指令集的 CPU。
腾讯云轻量 锐驰型 4核8G 120G 刊例价 230 元/月,4核16G 320 元/月,包年 85 折分别约 2346 元和 3264 元。阿里云轻量有个“智能体专用型”规格族,配置 2核6G 到 4核8G,自带 12,500 到 50,000 Credits 的模型额度,适合 Agent + 中小规模 RAG,但官方静态页面上我们没看到价格。
没有显卡的云服务器能跑本地小模型吗?
能跑 1.7B 到 8B 的小模型,但慢,而且上下文一开大内存就爆。我们自己测了一遍,结果如下。
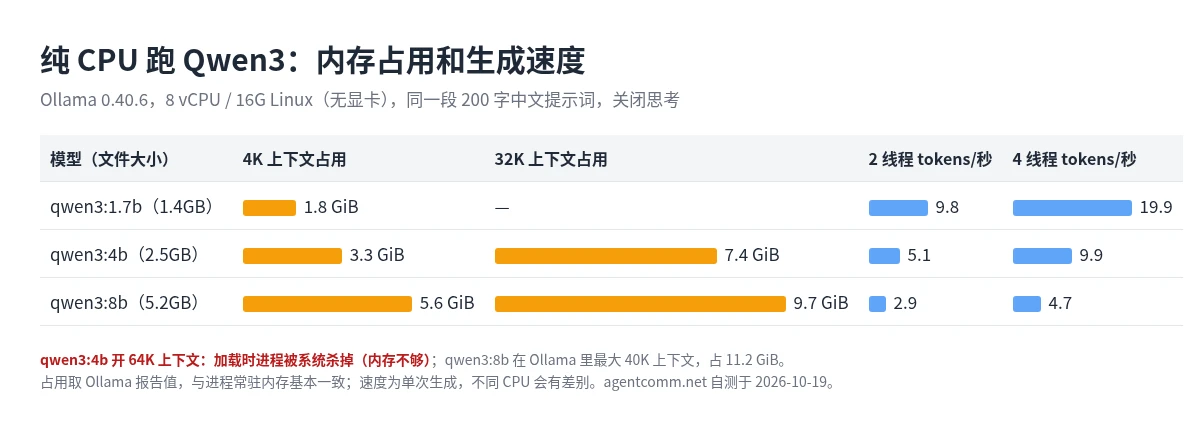
测法:Ollama 0.40.6,模型从官方模型库拉取,同一段约 200 字的中文提示词,关闭思考模式,分别限制 2 个和 4 个线程,模拟 2 核和 4 核机器。内存取 Ollama 报告的模型占用,和进程常驻内存基本一致。
有两个结果和我们预想的不一样。线程数基本决定速度:qwen3:4b 从 2 线程到 4 线程,每秒 token 数从 5.1 涨到 9.9,几乎翻倍,所以 2 核的机器跑模型基本没法用。
上下文比模型本身更吃内存:qwen3:4b 默认 4K 上下文只占 3.3 GiB,开到 32K 涨到 7.4 GiB,开到 64K 时在我们 16G 的机器上直接被系统杀掉了。
这对 Agent 很要命,因为 Hermes 官方要求模型上下文至少 64K(快速开始文档)。qwen3:8b 在 Ollama 里上下文上限是 40K,开满占 11.2 GiB,也达不到这个要求。
所以纯 CPU 的本地小模型更适合做分类、摘要、敏感词过滤这类短活,主模型还是走 API。真要跑,4B 短上下文用 4核8G 勉强,8B 开 32K 至少 4核16G,想快一点就上 8核16G。腾讯云轻量 通用型 8核16G 270G 刊例价 500 元/月,包年约 5100 元;这个钱买 API 额度能用很久,跑本地模型更多是为了数据不出服务器。
三种用法在阿里云、腾讯云上分别多少钱?
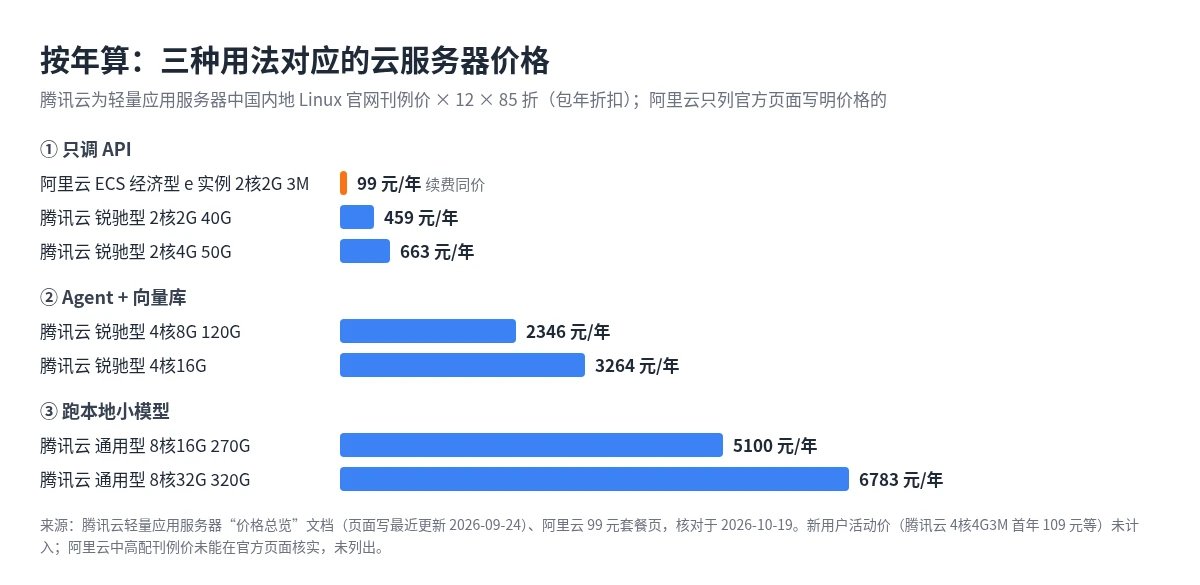
只调 API 一年 99 到 663 元,加向量库 2346 到 3264 元,纯 CPU 跑本地模型 5100 元起(腾讯云刊例价包年 85 折计)。
| 配置 | 价格 | 续费 | 入口(推广链接) | 来源 |
|---|---|---|---|---|
| 阿里云 ECS 经济型 e 实例 2核2G、3M 固定带宽、40G ESSD Entry | 99 元/年(日常价 1507.56 元/年) | 续费同价,锁价到 2029-03-31;限购 1 台 | 阿里云云小站(推广链接) | 99 元套餐页 |
| 阿里云轻量 OpenClaw/Hermes 镜像 + Token Plan | “轻量服务器+Token Plan组合购,68元起” | 以下单页为准 | 阿里云 AI Agent 部署活动(推广链接) | 部署活动页 |
| 阿里云轻量 智能体专用型 2核6G–4核8G,含 12,500–50,000 Credits | 官方静态页未显示 | 以下单页为准 | 阿里云 AI Agent 部署活动(推广链接) | 实例规格族文档 |
| 腾讯云轻量 4核4G3M(新用户) | 首年 109 元 | 按官网价,或走续费专区;每个实名主体限 1 台,活动到 2026-12-30 | 腾讯云采购季活动(推广链接) | 轻量特惠页 |
| 腾讯云轻量 锐驰型 2核4G 50G | 65 元/月,包年约 663 元 | 刊例价,包 6–11 个月 88 折、12 个月起 85 折 | 腾讯云特惠专区(推广链接) | 价格总览 |
| 腾讯云轻量 锐驰型 4核8G 120G | 230 元/月,包年 2346 元 | 同上 | 腾讯云特惠专区(推广链接) | 价格总览 |
| 腾讯云轻量 锐驰型 4核16G | 320 元/月,包年约 3264 元 | 同上 | 腾讯云特惠专区(推广链接) | 价格总览 |
| 腾讯云轻量 通用型 8核16G 270G 18M | 500 元/月,包年 5100 元 | 同上 | 腾讯云特惠专区(推广链接) | 价格总览 |
核对于 2026-10-19。腾讯云为中国内地地域 Linux 刊例价;锐驰型是 200M 峰值带宽、不限流量,通用型带月流量包,超出部分中国内地 0.8 元/GB。腾讯云产品介绍页上个别配置的显示价和价格总览文档不一致(例如入门型 2核2G),本文以价格总览文档为准。阿里云 4核8G、4核16G 等中高配的刊例价我们没能在官方静态页面核实,以下单页为准。
腾讯云活动页还写着“4核4G服务器新客 38元/年起,支持 OpenClaw/Hermes 等热门镜像”,阿里云活动页标题是“¥38/年,部署你的第一个 AI Agent”,两家的 38 元都是限量新客价,具体配置以活动卡片为准。两家整体的价格、续费和备案差异见 阿里云和腾讯云怎么选,OpenClaw 镜像怎么买见 OpenClaw 部署用阿里云还是腾讯云。
包年还是按月买?
先按月买一个月试,跑稳了再包年。
Agent 这类项目最常见的情况是配置买错:买小了浏览器工具崩,买大了 8 核机器每天闲着。腾讯云轻量包 12 个月起是 85 折,按月和包年一年差 15%,比配置买错的损失小得多。阿里云 99 元 e 实例本来就是包年价,直接买就行,不够再加一台。
一台机器同时跑 Agent、向量库和本地模型,内存要把三样加起来。我们测的 qwen3:8b 开 32K 是 9.7 GiB,再加 Milvus 推荐的 16G,单机得 32G 起步,这时候拆成两台更划算。
常见问题
只调 API 的 AI Agent 要多大服务器?
2核4G 足够,2核2G 也能跑。Hermes Agent 官方 Docker 文档写最低 1 核、1 GB 内存,推荐 2 核、2–4 GB,开浏览器自动化至少 2 GB。模型推理在云端,服务器只负责调度和工具调用。核对于 2026-10-19。
加向量数据库要多少内存?
看用哪个向量库。Dify 的 Docker Compose 默认带 Weaviate,官方最低是 CPU ≥ 2 核、内存 ≥ 4 GiB;单独部署 Milvus 单机版,官方要求内存 8G、推荐 16G,CPU 推荐 4 核以上。核对于 2026-10-19。
没有显卡的云服务器能跑本地大模型吗?
能跑小模型,但慢。我们在 8 vCPU、16G 内存的 Linux 机器上用 Ollama 测:qwen3:1.7b 4 线程每秒约 19.9 个 token,qwen3:4b 约 9.9,qwen3:8b 约 4.7。qwen3:8b 开 32K 上下文占 9.7 GiB 内存。测试机不是云服务器,云上的 vCPU 速度会有差别。测于 2026-10-19。
本地小模型能直接给 Hermes 当主模型吗?
在 16G 的机器上不太行。Hermes 官方要求模型上下文至少 64K,我们测 qwen3:4b 开 64K 上下文时进程因内存不够被系统杀掉,qwen3:8b 在 Ollama 里上下文上限是 40K。主模型走 API、本地小模型只做分类或摘要这类小活更现实。
腾讯云轻量应用服务器 4核8G 多少钱?
腾讯云价格总览文档列的中国内地 Linux 刊例价:锐驰型 4核8G 120G 230 元/月,入门型 4核8G 210 元/月,通用型 4核8G 230 元/月;包 12 个月及以上 85 折,锐驰型 4核8G 包年 2346 元。新用户活动另有“4核4G3M 首年 109 元”。核对于 2026-10-19。
阿里云中高配轻量服务器多少钱?
我们没能在阿里云官方静态页面上核实 4核8G、4核16G 的刊例价,所以本文不写。阿里云官方页面写明价格的是 ECS 经济型 e 实例 2核2G 99 元/年(续费同价)和 OpenClaw/Hermes 镜像“轻量服务器+Token Plan组合购,68元起”。其他配置以下单页为准。
本文要点
- AI Agent 要多大的服务器,看模型跑在哪:模型走云端 API 时,Agent 本身很轻,Hermes 官方推荐 2 核、2–4 GB,买 2核4G 就够,阿里云 ECS 经济型 e 实例 2核2G 99 元/年也能跑;加向量库做知识库,Dify 自带 Weaviate 最低 2核4G,单独跑 Milvus 官方要求内存 8G 起、推荐 16G,按 4核8G 起步;想在 CPU 上跑本地小模型,我们实测 qwen3:8b 开 32K 上下文占 9.7 GiB、4 线程每秒约 4.7 个 token,至少 4核16G。
- 腾讯云轻量应用服务器刊例价 2核4G 65 元/月、4核8G 230 元/月、4核16G 320 元/月,包年 85 折。
- 核对于 2026-10-19。
信息来源阿里云 99 元套餐页 · 腾讯云轻量特惠页 · 腾讯云轻量价格总览 · Hermes Agent 官方 Docker 文档
最后更新 · 价格核对 2026-10-19
引用本文部署 AI Agent 要什么配置的云服务器?只调 API、加向量库、跑本地小模型三种情况怎么选(2026) — https://www.agentcomm.net/zh/ai-agent-cloud-server-spec/