Ornith-1.5-122B 要什么配置?本地、云 GPU 还是直接用 API(2026)
直接回答
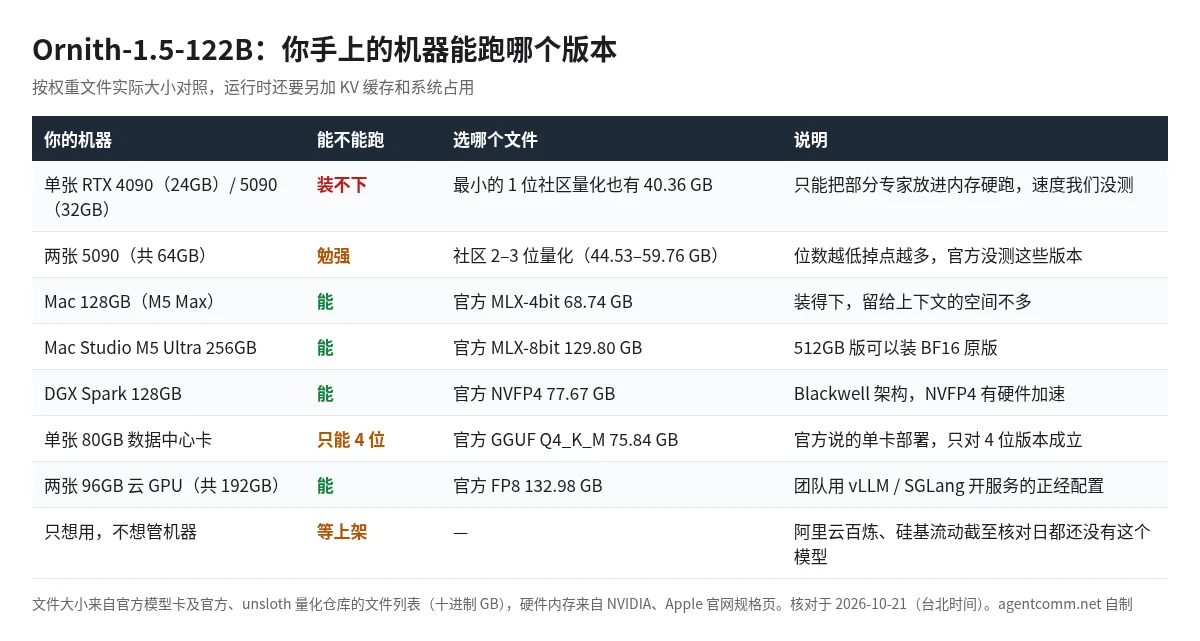
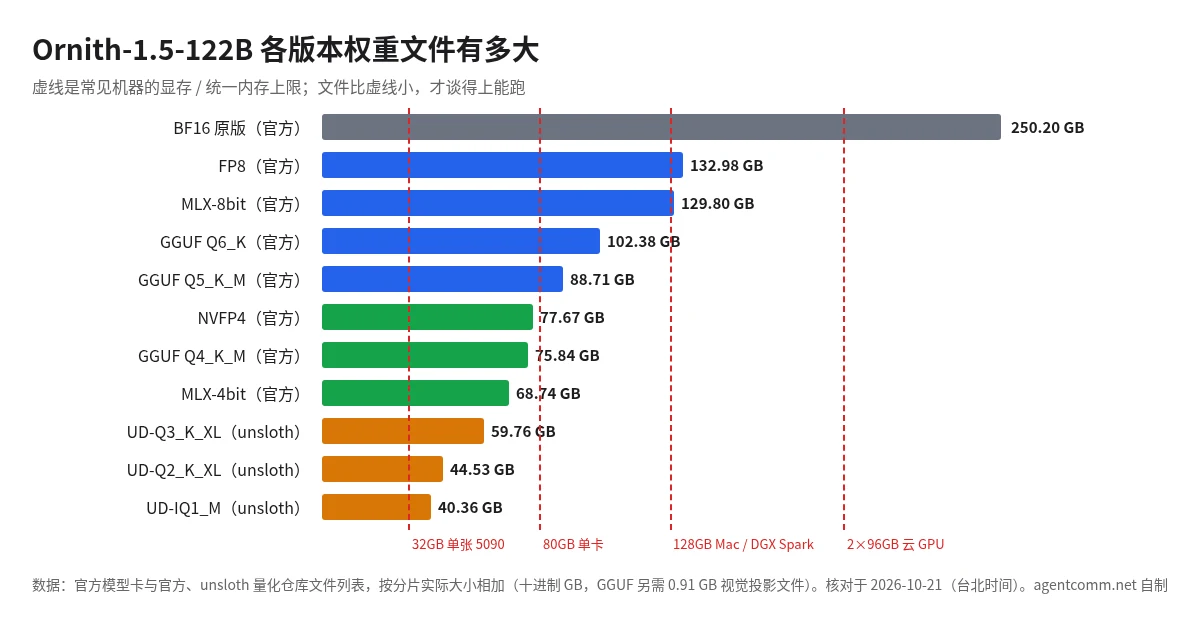
个人想在自己机器上跑 Ornith-1.5-122B,门槛是 128GB 统一内存:M5 Max 128GB 的 MacBook Pro、Mac Studio,或 128GB 的 DGX Spark,跑官方 4 位版本(MLX-4bit 68.74 GB、NVFP4 77.67 GB)。单张 RTX 4090、5090 装不下,社区最小的 1 位量化也有 40.36 GB。官方说的单张 80GB 显卡只对 4 位版本成立,原版 BF16 权重是 250.20 GB。团队用 vLLM 开服务,官方 FP8 版 132.98 GB,阿里云 gn8v 两卡(2×96GB)装得下。阿里云百炼、硅基流动截至 2026-10-21 都没有上架这个模型。文件大小是按官方和 unsloth 仓库的文件列表逐个相加的,核对于 2026-10-21(台北时间)。
本文怎么来的:模型参数、跑分和部署说明来自 Ornith 官方模型卡和 10 月 20 日的官方发布说明。各版本文件多大,是我们把官方 FP8、NVFP4、GGUF、MLX 仓库和 unsloth GGUF 仓库的文件列表拉下来,按分片一个个加出来的,用的是十进制 GB。硬件内存来自 NVIDIA DGX Spark 官网、Mac Studio 技术规格、MacBook Pro 技术规格 和 NVIDIA RTX 5090 页面,云 GPU 规格来自 阿里云 GPU 实例规格族文档。全部核对于 2026-10-21(台北时间)。这个模型我们自己没跑过,所以文中不写速度。
Ornith-1.5-122B 个人能跑吗?
能,但得是 128GB 内存的机器,游戏卡不行。
Ornith-1.5-122B 是 Ornith 团队 10 月 20 日放出开放权重的 MoE 模型,MIT 许可,能看图,上下文 262,144 tokens。它是推理模型,默认先吐一段思考再给答案,跑 Agent 的时候 token 会比普通模型多。激活参数官方模型卡里没写。
| 你的机器 | 能跑吗 | 用哪个文件(实际大小) | 依据 |
|---|---|---|---|
| 单张 RTX 4090(24GB)或 RTX 5090(32GB) | 装不下 | 社区最小的 UD-IQ1_M 也有 40.36 GB | RTX 5090 页面、RTX 4090 页面 |
| 两张 RTX 5090(共 64GB) | 勉强 | unsloth UD-Q2_K_XL 44.53 GB 或 UD-Q3_K_XL 59.76 GB | 同上 |
| MacBook Pro 或 Mac Studio,M5 Max 128GB | 能 | 官方 MLX-4bit 68.74 GB | MacBook Pro 规格、Mac Studio 规格 |
| Mac Studio M5 Ultra 256GB 或 512GB | 能 | 官方 MLX-8bit 129.80 GB;512GB 装得下 BF16 的 MLX 原版 244.26 GB | Mac Studio 规格 |
| DGX Spark 128GB | 能 | 官方 NVFP4 77.67 GB | DGX Spark 官网 |
| 单张 80GB 卡(如阿里云 gn7e 单卡) | 只能跑 4 位 | 官方 GGUF Q4_K_M 75.84 GB | 阿里云 GPU 规格族文档 |
| 两张 96GB 卡(如阿里云 gn8v 两卡规格) | 能 | 官方 FP8 132.98 GB | 同上 |
| 不想管机器,只想调 API | 国内暂无 | — | 百炼模型列表、硅基流动模型中心 |
核对于 2026-10-21(台北时间)。文件大小不含 KV 缓存;GGUF 版要看图的话,还得另加一个 0.91 GB 的视觉投影文件。
4090、5090 为什么跑不了?
差得太远了。最小的社区量化 40.36 GB,5090 的 32GB 都装不下,4090 就更别提。
llama.cpp 可以把一部分专家层放到内存里,显存加内存凑够文件大小就能启动。放到内存里的那部分要靠 CPU 算,慢到什么程度我们没测,不乱给数。1 位、2 位这种量化掉点多少,官方也没测过,模型卡上的跑分全是原版的成绩。
两张 5090 凑 64GB 能装下 2 位、3 位版本,游戏卡里也就这条路。花两张 5090 的钱去跑一个 2 位量化,我是舍不得。
Mac 和 DGX Spark 选哪个?
两个都是 128GB 起步才行,Mac 跑官方 MLX 版,DGX Spark 跑官方 NVFP4 版。
NVFP4 是 NVIDIA 给 Blackwell 架构做的 4 位格式(NVIDIA 技术博客),DGX Spark 用的 GB10 正好是 Blackwell,这个版本就是给它准备的。Mac 上没有这套硬件加速,老老实实用 MLX-4bit,68.74 GB,比 NVFP4 还小一点。
DGX Spark 有 64GB 和 128GB 两种配置,买 64GB 那台的,这个模型就别想了。M5 Max 的 Mac 同理,64GB 版装不下,MacBook Pro 还得选 40 核图形处理器的 M5 Max 才配得到 128GB。Mac Studio 的 M5 Ultra 底配是 96GB,装得下 4 位文件,但给上下文留的地方比 128GB 小一截;想跑 8 位,得上 256GB。
Ollama 已经上架了 ornith-1.5:122b,标签页写的是 73GB 到 77GB(Ollama 模型库),Mac 和 DGX Spark 都可以直接拉。
官方说的单卡部署靠谱吗?
只对 4 位版本靠谱。原版 250 GB、FP8 版 133 GB,哪个都塞不进一张 80GB 的卡。
模型卡原话是 single 80GB GPU,到了发布说明又成了一张 DGX。DGX 是 NVIDIA 一整个系列的产品名,从桌面上的 DGX Spark 到机房里的整机都叫 DGX,官方没说是哪一台。
更容易踩的坑在模型卡自己给的 vLLM 启动命令上:它拉的是 BF16 原版仓库,还把上下文开到了 262,144。照抄到一张 80GB 卡上,权重都加载不完。单卡要用的话,A100、H100 这类非 Blackwell 的卡选 GGUF Q4_K_M,75.84 GB,剩给 KV 缓存的也就几 GB,长上下文别指望开满。
配置文件里每 4 层才有 1 层是完整注意力,其余是线性注意力,所以 KV 缓存会比同尺寸的纯注意力模型省。具体省多少要看框架实现,我们没测。
租云 GPU 怎么配?
团队开服务,直接两张 96GB 跑官方 FP8。一个人只是试试的话,单张 80GB 跑 4 位版本就够了。
对照阿里云的 GPU 规格族文档:gn7e 单卡 80GB;gn8v 每卡 96GB HBM3、支持 FP8,ecs.gn8v-2x.8xlarge 是两卡、共 192GB 显存,装下 132.98 GB 的 FP8 版还剩将近 60GB 给并发和上下文,这是我们觉得团队用最顺手的一档。新一代 gn9gc 是 Blackwell 架构、支持 FP4,但单卡 72GB,比 NVFP4 版的 77.67 GB 小,得两卡起,而且文档写着还在邀测,要提工单申请。
价格我们没写。阿里云 GPU 实例按地域、规格和计费方式定价,我们没在官方静态页面上找到能直接引用的刊例价,以控制台下单页和官方价格计算器为准。按量付费先开几个小时试,比一上来包月稳。
阿里云的 AIGC 活动页(推广链接) 主推函数计算的 Serverless GPU,按量付费,页面上的例子是 16GB GPU 跑生图和语音模型。它装不下 122B,适合先拿小模型把部署流程走一遍,正式跑 Ornith 还得去 ECS 开 gn8v 这类实例。
能不能直接调 API?
国内暂时不能。阿里云百炼的模型列表、硅基流动的模型中心,10 月 21 日都没有 Ornith 系列。
官方模型卡里说的 API,其实是自己用 vLLM 或 SGLang 起一个 OpenAI 兼容接口,再把 Hermes Agent、OpenClaw、OpenCode 这类工具指过去。它的上下文 262,144 tokens,满足 Hermes 至少 64K 的要求,Hermes 那台机器本身要多大见 Hermes Agent 部署要几核几 G。模型放在 GPU 机器上、Agent 放在普通云服务器上,分开买更灵活,Agent 那台怎么配见 部署 AI Agent 要什么配置的云服务器。
跑分能信多少?
只能当参考,下面的数全是官方自测,来自官方模型卡的表格。
| 测试 | Ornith-1.5-122B | 同表里的 Qwen3.8-Flash-Next(125B) |
|---|---|---|
| SWE-bench Verified | 84.5 | 82.8 |
| Terminal-Bench 2.1 | 81.2 | 83.4 |
官方自测,来源:Ornith 官方模型卡,核对于 2026-10-21。
我把官方发布说明里的数和模型卡表格逐个对了一遍,HLE 对不上。发布说明写 0.446,模型卡里带工具是 48.0、不带工具是 37.68。巧的是 8 月那篇官方博客里,397B 版不带工具的 HLE 正好是 44.6,我猜是复制的时候串了行。Terminal-Bench 2.1 也差了 0.1。本文一律按模型卡表格写。
还有模型卡里提了一嘴的 122B-Mobile 版,官方仓库到现在连个影子都没有。手机上跑 122B,先听听就好。
常见问题
Ornith-1.5-122B 最低要多大显存?
看版本。官方 4 位版本里最小的是 MLX-4bit 68.74 GB,NVIDIA 卡上能用的 GGUF Q4_K_M 是 75.84 GB、NVFP4 是 77.67 GB;社区 unsloth 最小的 UD-IQ1_M 是 40.36 GB。运行时还要另加 KV 缓存。单张 24GB 或 32GB 的显卡装不下任何一个版本。核对于 2026-10-21。
官方说单卡就能部署,是真的吗?
只对 4 位量化版本成立。官方模型卡写的是可以在单张 80GB 显卡上运行,但官方 BF16 原版权重 250.20 GB、FP8 版 132.98 GB,都放不进一张 80GB 卡;放得下的是 GGUF Q4_K_M(75.84 GB)和 NVFP4(77.67 GB),剩给上下文的空间只有几 GB。
Ornith-1.5-122B 激活参数是多少?
官方模型卡没有写。官方配置文件里是 256 个专家,每个 token 激活其中 8 个,另有 1 个共享专家,一共 48 层。我们没有自己去算激活参数,以官方公布为准。
有手机能跑的 Ornith-1.5-122B-Mobile 吗?
官方模型卡提到可以通过量化的 Ornith-1.5-122B-Mobile 版本部署到移动设备,但截至 2026-10-21(台北时间),Ornith 官方模型仓库里没有这个版本,查不到文件和大小。8 月发布的 Ornith-1.5-9B 有手机版,别混了。
国内能直接调 Ornith-1.5-122B 的 API 吗?
暂时不能。截至 2026-10-21,阿里云百炼的模型列表和硅基流动的模型中心都没有 Ornith 系列。官方模型卡给的用法是自己用 vLLM 或 SGLang 起一个 OpenAI 兼容接口。
本文要点
- 个人想在自己机器上跑 Ornith-1.5-122B,门槛是 128GB 统一内存:M5 Max 128GB 的 MacBook Pro、Mac Studio,或 128GB 的 DGX Spark,跑官方 4 位版本(MLX-4bit 68.74 GB、NVFP4 77.67 GB)。
- 单张 RTX 4090、5090 装不下,社区最小的 1 位量化也有 40.36 GB。
- 官方说的单张 80GB 显卡只对 4 位版本成立,原版 BF16 权重是 250.20 GB。
信息来源NVIDIA DGX Spark 官网 · Mac Studio 技术规格 · MacBook Pro 技术规格 · NVIDIA RTX 5090 页面
最后更新 · 价格核对 2026-10-21
引用本文Ornith-1.5-122B 要什么配置?本地、云 GPU 还是直接用 API(2026) — https://www.agentcomm.net/zh/ornith-1-5-122b-hardware/