Clover-35B 是什么?扩散 MoE:16GB 端侧 vs BF16 常驻 vs 云 GPU(2026)
直接回答
Clover-35B-A3B-Preview 是 DiffuSpace 开源(Apache-2.0)的 MoE 扩散语言模型,总参约 35B、激活约 3B,支持思考模式;和同档自回归 MoE 比,主打块扩散并行生成速度(官方自报)。官方称 INT4 可在 16GB 显存(RTX 5070 Ti)上部署;BF16 权重约 69GB,单卡要能装下权重再加推理状态;要 7×24 满速或给别人访问,上云 GPU,前端 Agent 另挂轻量机。吞吐与 Agent/编程基准都是官方自报,我们没复跑。上下文 128K 以官方模型卡为准。核对于 2026-10-28(台北时间)。
快速推荐:按你的情况选
活动页主推免运维 Serverless GPU、按量付费;页上例子多为约 16GB GPU 跑生图/语音。装不下 Clover BF16 约 69GB,练流程够(我们 2026-10-28 核对)。
福利页写 Token Plan 可抵扣由阿里云百炼提供的全量模型(我们 2026-10-28 核对)。Clover 本身国内托管 API 我没核到上架,别当「已有 Clover 接口」。
活动页写「轻量服务器+Token Plan组合购,68元起」(我们 2026-10-28 核对)。Agent 程序本身轻,和 GPU 机分开买更灵活。
价格核对于 2026-10-28,活动价和库存随时变,下单前以官方页面为准。带 ↗ 的按钮是推广链接,价格不变。
本文怎么来的:定义、MoE 规模、思考模式、吞吐与端侧 INT4 口径摘自 DiffuSpace 官方博客。BF16 约 69GB、128K 上下文、Apache-2.0 摘自官方模型卡与代码仓 README。2026-10-28(台北时间)又打开对过。我没下载权重,也没在本机或云上跑过 Clover,所以不写「实测速度」。
16GB 能试跑,装不下 BF16 常驻。
DiffuSpace 开源了 Clover-35B-A3B-Preview:Apache-2.0 的 MoE 扩散语言模型,总参约 35B、激活约 3B,支持思考模式。和同档自回归 MoE 比,官方主打块扩散并行生成——速度数字一律他们自报,我们没复跑。
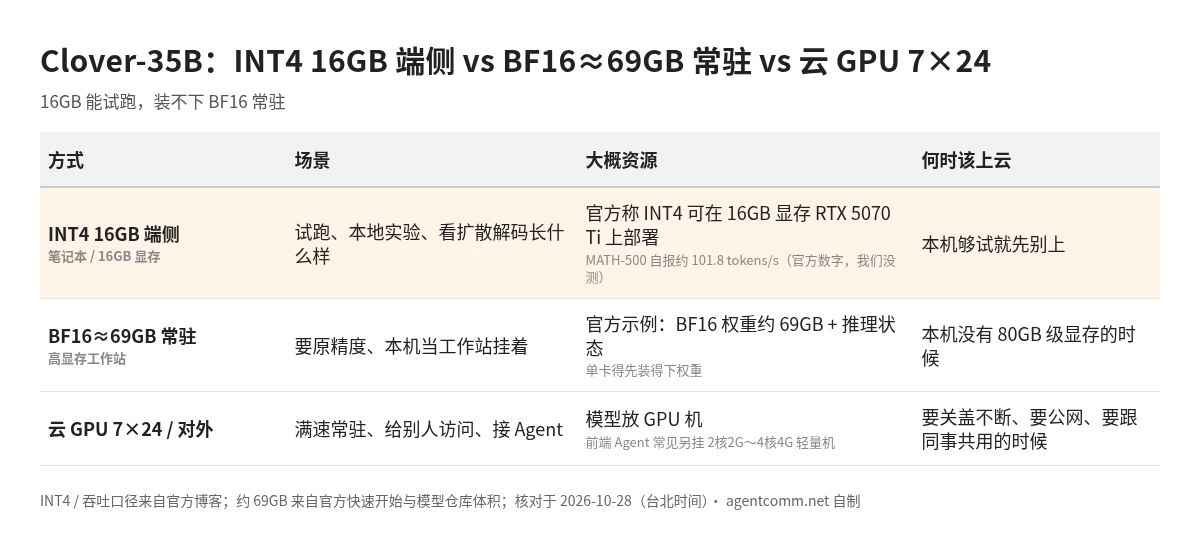
一眼表:16GB 端侧 vs BF16 常驻 vs 云 GPU 7×24
| 方式 | 场景 | 大概资源 | 何时该上云 |
|---|---|---|---|
| 笔记本 / 16GB INT4 端侧 | 试跑、本地实验、看扩散解码长什么样 | 官方称 INT4 可在 16GB 显存 RTX 5070 Ti 上部署;MATH-500 自报约 101.8 tokens/s(官方数字,我们没测) | 本机够试就先别上 |
| BF16 高显存常驻 | 要原精度、本机当工作站挂着 | 官方示例:BF16 权重约 69GB + 推理状态;单卡得先装得下权重 | 本机没有 80GB 级显存的时候 |
| 云 GPU 7×24 / 对外 | 满速常驻、给别人访问、接 Agent | 模型放 GPU 机;前端 Agent 常见另挂 2核2G~4核4G 轻量机 | 要关盖不断、要公网、要跟同事共用的时候 |
INT4 / 吞吐口径来自官方博客;约 69GB 来自官方快速开始与模型仓库体积。核对:2026-10-28(台北时间)。
官方博客还写了单卡 GB300(BF16、batch size=1)内部 Agent 场景约 680 tokens/s、单卡 H200 约 515 tokens/s。短页只留这两个数当量级参考——这两个数都是官方自报的,我们没跑过。Agent / 编程那一长串基准(SWE-bench Verified、Terminal-Bench 等)也是官方表上的数,短页不抄,也不拿来当卖点。
128K 和许可证,按模型卡写
上下文 128K(合计最多 131,072 tokens)写在官方模型卡和代码仓 README 里;博客正文没直接写死,所以本文按模型卡。许可证 Apache-2.0,以官方许可证文件为准。
推理路径官方点了 Transformers 试跑、SGLang 做服务与评测、以及本地侧的 llama.cpp(自推测解码)。SFT 代码官方写「即将放出」——短页不假装已经能一键微调。
满速、常驻、给别人访问:去哪挂?
本机 INT4 试完,下一步通常不是把笔记本焊在桌上。
要 BF16 常驻或更高并发,对照 Ornith 硬件页里的云 GPU 段 看规格族怎么读——那页模型更大,入口通用。想先把「云上起推理」的流程过一遍,入口在阿里云 AIGC 页(推广链接):页上主推函数计算 Serverless GPU,例子多是约 16GB 显存跑生图 / 语音,装不下 Clover 的 BF16 约 69GB,练手够。正式装 BF16,还得去 ECS 一类开够显存的 GPU 实例;刊例价静态页不稳定,短页不写死价。
模型在 GPU 上了,还要 7×24 给别人访问或接 OpenClaw / Hermes,把 Agent 程序另挂轻量机更干净。粗表见 部署 AI Agent 要什么配置;落地对照 OpenClaw 云服务器、Hermes 几核几 G。暂时不想自托管模型、只想先调国内已有模型顶着用,看阿里云 AI 福利页(推广链接) 的 Token Plan——页上写可抵扣百炼全量模型。我没核到国内托管平台已上架 Clover 本身。
2026-10-28 打开活动页:轻量+Token Plan 68 元起。双 11 总览见 2026 双 11 云服务器怎么买。到手什么价,以下单页实时显示为准。
先分清自己要的是「16GB 试一下」还是「69GB 挂着跑」,再点活动页。
常见问题
Clover-35B-A3B-Preview 是什么?
DiffuSpace 开源(Apache-2.0)的 MoE 扩散语言模型,总参约 35B、激活约 3B,支持思考模式;和同档自回归 MoE 比,官方主打块扩散并行生成速度。2026-10-28(台北时间)核对过。
笔记本 16GB 显存能跑吗?
官方写已在仅 16GB 显存的 RTX 5070 Ti 上做 INT4 量化部署,并自报 MATH-500 生成约 101.8 tokens/s。他们报的,不是我们测的。试跑可以;BF16 常驻别指望这档显存。
BF16 要多大显存?
官方快速开始写:一张 GPU 要装得下 BF16 权重(约 69GB)再加推理状态。ModelScope 仓库存储体积约 69.3GB,和「约 69GB」对得上。具体卡型官方没锁成一张采购表。
官方写的 680 / 515 tok/s 是你们测的吗?
不是。官方博客:单卡 GB300、BF16、batch size=1,内部 Agent 场景约 680 tokens/s;单卡 H200 约 515 tokens/s。都是官方写的,我们没复跑。
上下文多长?许可证呢?
官方模型卡 / 代码仓 README 写 128K(合计最多 131,072 tokens)。许可证 Apache-2.0,以官方许可证文件为准。博客正文没直接写死 128K,短页按模型卡来。
本文要点
- Clover-35B-A3B-Preview 是 DiffuSpace 开源(Apache-2.0)的 MoE 扩散语言模型,总参约 35B、激活约 3B,支持思考模式;和同档自回归 MoE 比,主打块扩散并行生成速度(官方自报)。
- 官方称 INT4 可在 16GB 显存(RTX 5070 Ti)上部署;BF16 权重约 69GB,单卡要能装下权重再加推理状态;要 7×24 满速或给别人访问,上云 GPU,前端 Agent 另挂轻量机。
- 吞吐与 Agent/编程基准都是官方自报,我们没复跑。
信息来源阿里云 AIGC 活动页 · 阿里云 AI 福利页 · 阿里云 OpenClaw/Hermes 部署活动页
最后更新 · 价格核对 2026-10-28
引用本文Clover-35B 是什么?扩散 MoE:16GB 端侧 vs BF16 常驻 vs 云 GPU(2026) — https://www.agentcomm.net/zh/clover-35b-diffusion-moe-vs-cloud/